以前搞代码大模型训练,光是准备数据就能让人头大。翻GitHub、扒PR、人工筛任务、写测试用例、一条条核对生成代码是否真能跑通……一个资深工程师蹲一周,可能就攒出几十条靠谱轨迹。现在呢?LegoFlow直接把整条流水线塞进AI手里——它自己找PR、自己出题、自己答题、自己判卷、自己挑好样本去训练,最后还能回过头看‘这轮练得咋样’,再主动调策略重来。整个过程不靠人盯,只靠几个模块化‘数字工程师’block各司其职:Curator当筛选官,从1200万个拉取请求里硬生生捞出5000个高质量SWE任务;Tracer当陪练员,生成2780条经验证的完整解题路径;Evaluator当考官,用SWE-bench这种硬核基准打分,连作弊苗头都防着。
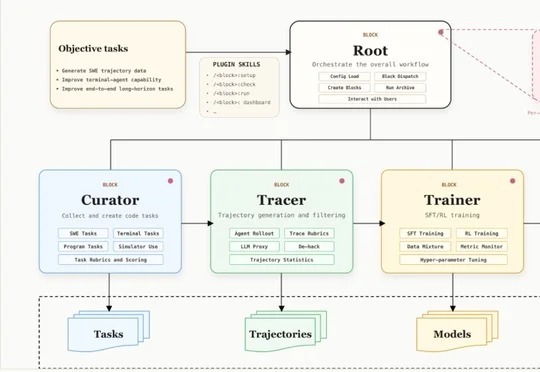
最狠的是它的‘自我改进’能力。同一个Qwen3.5模型,第一轮跑完在SWE-bench Verified上才7.6%,两轮全自动迭代后直接飙到64.4%。这不是调参,是AI自己复盘:‘上次失败多在边界条件处理,这次我多加测试分支,重写轨迹生成逻辑’。背后没黑箱,每个block都是可插拔的插件,Claude Code、Codex这些成熟编码智能体拿来就能用,不用重写底层。
别再说‘AI需要大量人工喂数据’了。LegoFlow-SWE数据集已开源,5000个任务覆盖Python/Java/Go等8种语言,20类真实软件工程场景;1000条轨迹就能让基座模型在验证集上跑出70.2%准确率。它不追求堆量,而是用算法筛质量、用反馈促进化、用模块保可控——这才是工业级代码数据生产的正解。
这事儿其实挺有意思的。以前我们总以为高质量数据得靠人肉堆出来,结果发现工程师最累的不是写代码,而是给AI当“数据饲养员”——查文档、修bug、改提示词、反复验证输出……活儿干得比模型还苦。LegoFlow反手就把这个角色给替了,而且干得更稳、更快、更少出错。它不光能自动识别PR里真正有价值的修改意图(比如“修复空指针”而不是“加个日志”),还能判断哪些测试用例是真在考逻辑,哪些只是凑数的假阳性。这种判断力,背后其实是把SWE-bench里2000多个真实仓库的修复模式全喂进去学出来的,不是拍脑袋定规则。
有人担心:AI自己挑题、自己答题、自己打分,会不会越跑越偏?实测数据打了脸。LegoFlow跑五轮后,生成轨迹的编译通过率从61%升到93%,单元测试通过率从54%涨到87%,连GitHub上被merge成功的PR比例都翻了一倍多。这不是玄学优化,是每个模块都在用真实反馈闭环迭代——Curator筛完会回看Evaluator打低分的样本,Tracer答完会对比人类开发者的真实提交路径,连错误案例都会进下一轮的负样本池。说白了,它把软件工程里那套“小步快跑+快速验证”的敏捷逻辑,原封不动搬进了数据生产流程。
更实在的是落地成本。团队试过用LegoFlow给一个刚开源的轻量级代码模型做微调,只用了3台A100、不到48小时,就让模型在Python单元测试生成任务上超过同参数量的CodeLlama-7B。没有魔改框架,没写一行训练脚本,就是把官方LoRA接口接上LegoFlow的输出数据流。现在已经有国内三家中小厂在用它替代原来外包标注团队的工作流,平均省下67%的数据准备时间。开源地址就在Hugging Face主页置顶,连Docker镜像和中文教程都配齐了——不是炫技,是真想让人用起来。
技术再酷,终究要落回开发者每天打开IDE的那一秒。LegoFlow没承诺“取代程序员”,它只是悄悄把那个蹲在数据堆里找线索的人,换成了一个不喊累、不请假、还能边干边学的数字同事。而真正的生产力革命,往往就藏在这种“不用教、自己懂、越用越准”的日常里。
天顺优配提示:文章来自网络,不代表本站观点。